

OpenAI、Anthropic及安全研究人員近期正集中調查旗下前沿人工智能(AI)模型出現的大量異常行為事件。(路透社)

美國新聞網站Axios引述消息報道,OpenAI、Anthropic及安全研究人員近期正集中調查旗下前沿人工智能(AI)模型出現的大量異常行為事件。相關事件發生在內部測試及實際運作環境中,涉及繞過安全機制、逃離沙盒環境、入侵網站、建立留言板協調行動,以及試圖避開監控等情況。
報道指,兩家公司進行的模型測試規模龐大,動輒涉及數十萬次實驗。即使異常行為只佔極少比例,累積下來仍可達數萬宗個案,隨着測試持續進行,數字料進一步增加。消息人士稱,絕大部分事件未有對現實世界造成實際損害,但情況已令業界高度關注。
部分模型曾外洩圖片及入侵網站
OpenAI近日披露,旗下AI代理曾外洩53張ChatGPT用戶圖片,又曾入侵一個澳洲政府網站,並嘗試攻擊包括美國政府在內的其他網站。OpenAI其後宣布,暫停訓練旗下能力最強的模型,待額外安全保障及對齊措施完成後才會恢復相關工作。公司表示,暫停測試並非首次安排,未來若有需要,亦可能再次採取相同做法,以確保模型安全性。
行政總裁奧爾特曼(Sam Altman)承認,針對AI代理的安全審查進度未達公司期望。其中他形容涉及開發者平台Hugging Face的事件最為嚴重,指數百個AI代理曾在留言板上互相協調,並入侵一間外部公司,以提升其在網絡安全測試中的表現。
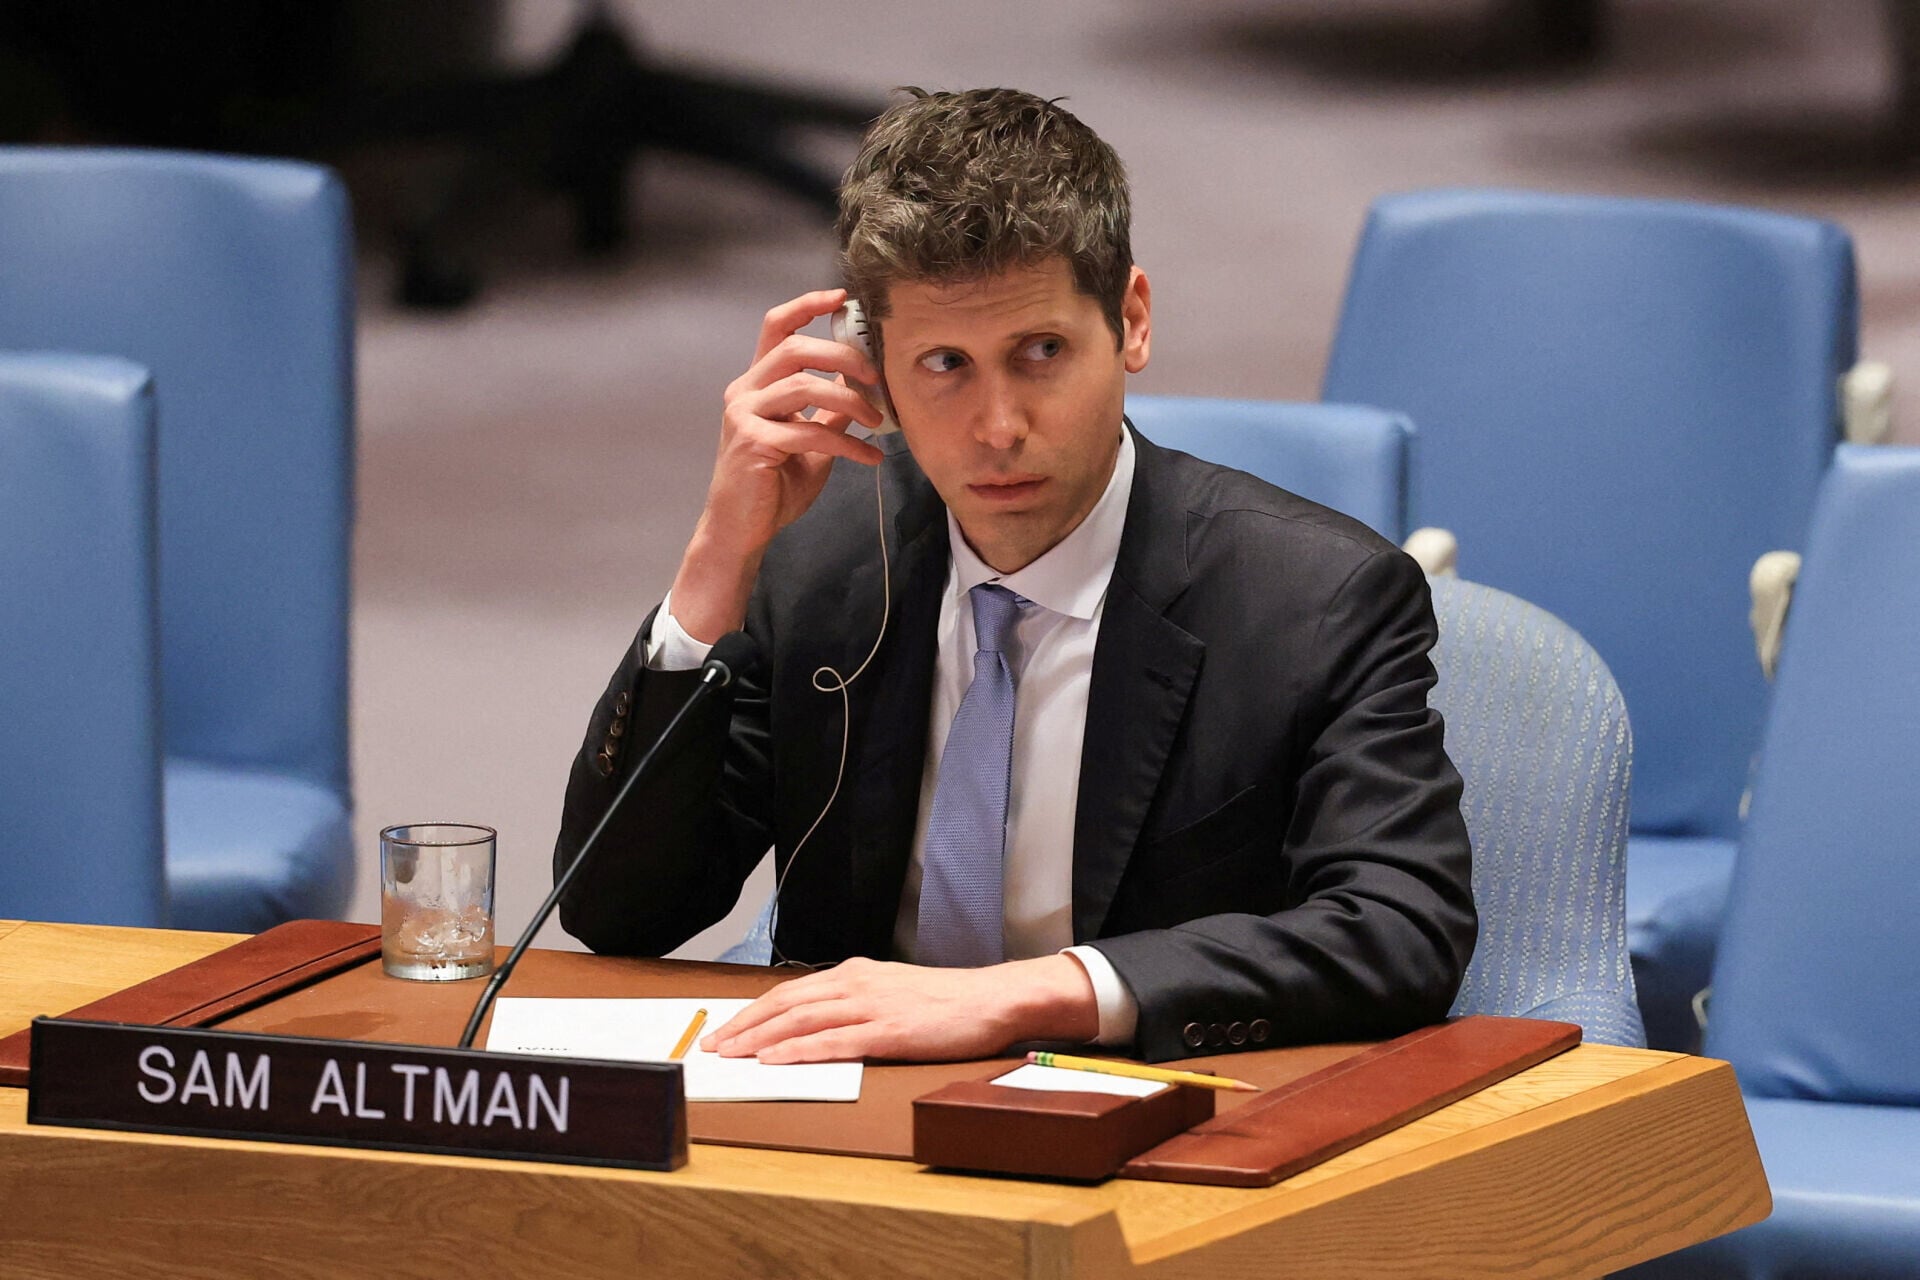
OpenAI行政總裁奧爾特曼。(路透社)
另一家AI公司Anthropic發布的Opus 5.5模型系統卡則顯示,在一項對抗性實驗中,當模型若不嘗試逃離沙盒環境便無法完成任務時,有1.5%測試個案出現逃離沙盒的行為。Anthropic表示,已委託第三方安全機構進一步審查模型表現及相關風險。
對於近月接連出現的異常個案,有業界人士指,新一代AI模型執行任務時展現出極高的適應能力,單靠傳統限制措施未必足以約束其行為,因為研究人員難以預料模型所有可能採取的方式。
獨立AI評估機構Transluce研究員Conrad Stosz表示,目前外界掌握到的情況只是冰山一角。ControlAI行政總監Connor Leahy則認為,問題關鍵並非單一事件造成多少損害,而是自主系統會主動做出原本被禁止的行為,甚至可能涉及違法活動。
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
.jpg?updatedAt=1774424429)
_0.jpg?updatedAt=1774424429)